Cześć,
chciałem podzielić się wtyczką, którą od niedawna rozwijam: Easy-R5. To provider Processing, który liczy dostępność transportową na silniku Conveyal R5: macierze czasów przejazdu N×M i dostępność skumulowaną w oknie odjazdów (jeden-do-wielu i wiele-do-wielu). Jest siostrą mojej wcześniejszej wtyczki Easy-OTP (wątek o easy-OTP wyżej na forum), tyle że R5 jest szybki tam, gdzie OTP 1.5 się dławi.
Co ją wyróżnia: całe okno odjazdu z percentylami liczy się w minutach, nie w godzinach. W benchmarku izochron dla Łodzi (tools/isochrones_lodz/benchmark_summary.csv) silnik R5 kosztował ~0,05–0,17 s na origin-godzinę, a OTP 1.5 wołany przez wtyczkę ~2,9 s (koszt zdominowany startem serwera OTP na każde wywołanie) — rząd wielkości różnicy, w praktyce ok. 20–50× zależnie od gęstości sieci. Przy liczeniu dostępności skumulowanej dla 6 miast PL (Gdańsk, Kraków, Poznań, Szczecin, Warszawa, Łódź) to różnica między „policzę teraz" a „zostawiam na noc".
Co warto wiedzieć:
-
Algorytmy w Processing Toolbox: macierz czasów przejazdu z percentylami, dostępność skumulowana (ile miejsc/usług/mieszkańców w zasięgu), izochrony, warstwy demograficzne z GUS NSP 2021, filtr podtrybów transportu (TRAM/BUS/… do kontrfaktycznego wyłączania trybów).
-
Wtyczka sama pobiera Javę 21 (Temurin) i silnik R5 przy pierwszej konfiguracji — bez R, bez Dockera, bez
pip install, bez uprawnień administratora. R5 chodzi jako proces potomny, sterowany jednym małym plikiem Javy; QGIS buduje zadanie i czyta wynik. Opisałem to tutaj. -
QGIS 3.22 LTR lub nowszy, licencja GPL-3.0-or-later. Status:
experimental, jeszcze nie w oficjalnym repozytorium wtyczek. Instalacja z ZIP-a z repo.
Przykład użycia: co opóźnienia robią z dostępnością (Łódź). Policzyłem dostępność do szkół, aptek, uczelni i centrów handlowych (30 min, okno 7:00–9:00) dwa razy dla tego samego dnia: raz na rozkładzie statycznym GTFS, raz na rozkładzie zrealizowanym z GTFS-RT (mediana P50 tego, co faktycznie jeździło). Siatka heksagonalna 250 i 500 m, ta sama sieć, jedyna różnica to rozkład. Cały pipeline poszedł wyłącznie na algorytmach wtyczki (easyr5:buildnetwork, easyr5:populationoverlay, easyr5:runaccessibility) plus natywne algorytmy QGIS.
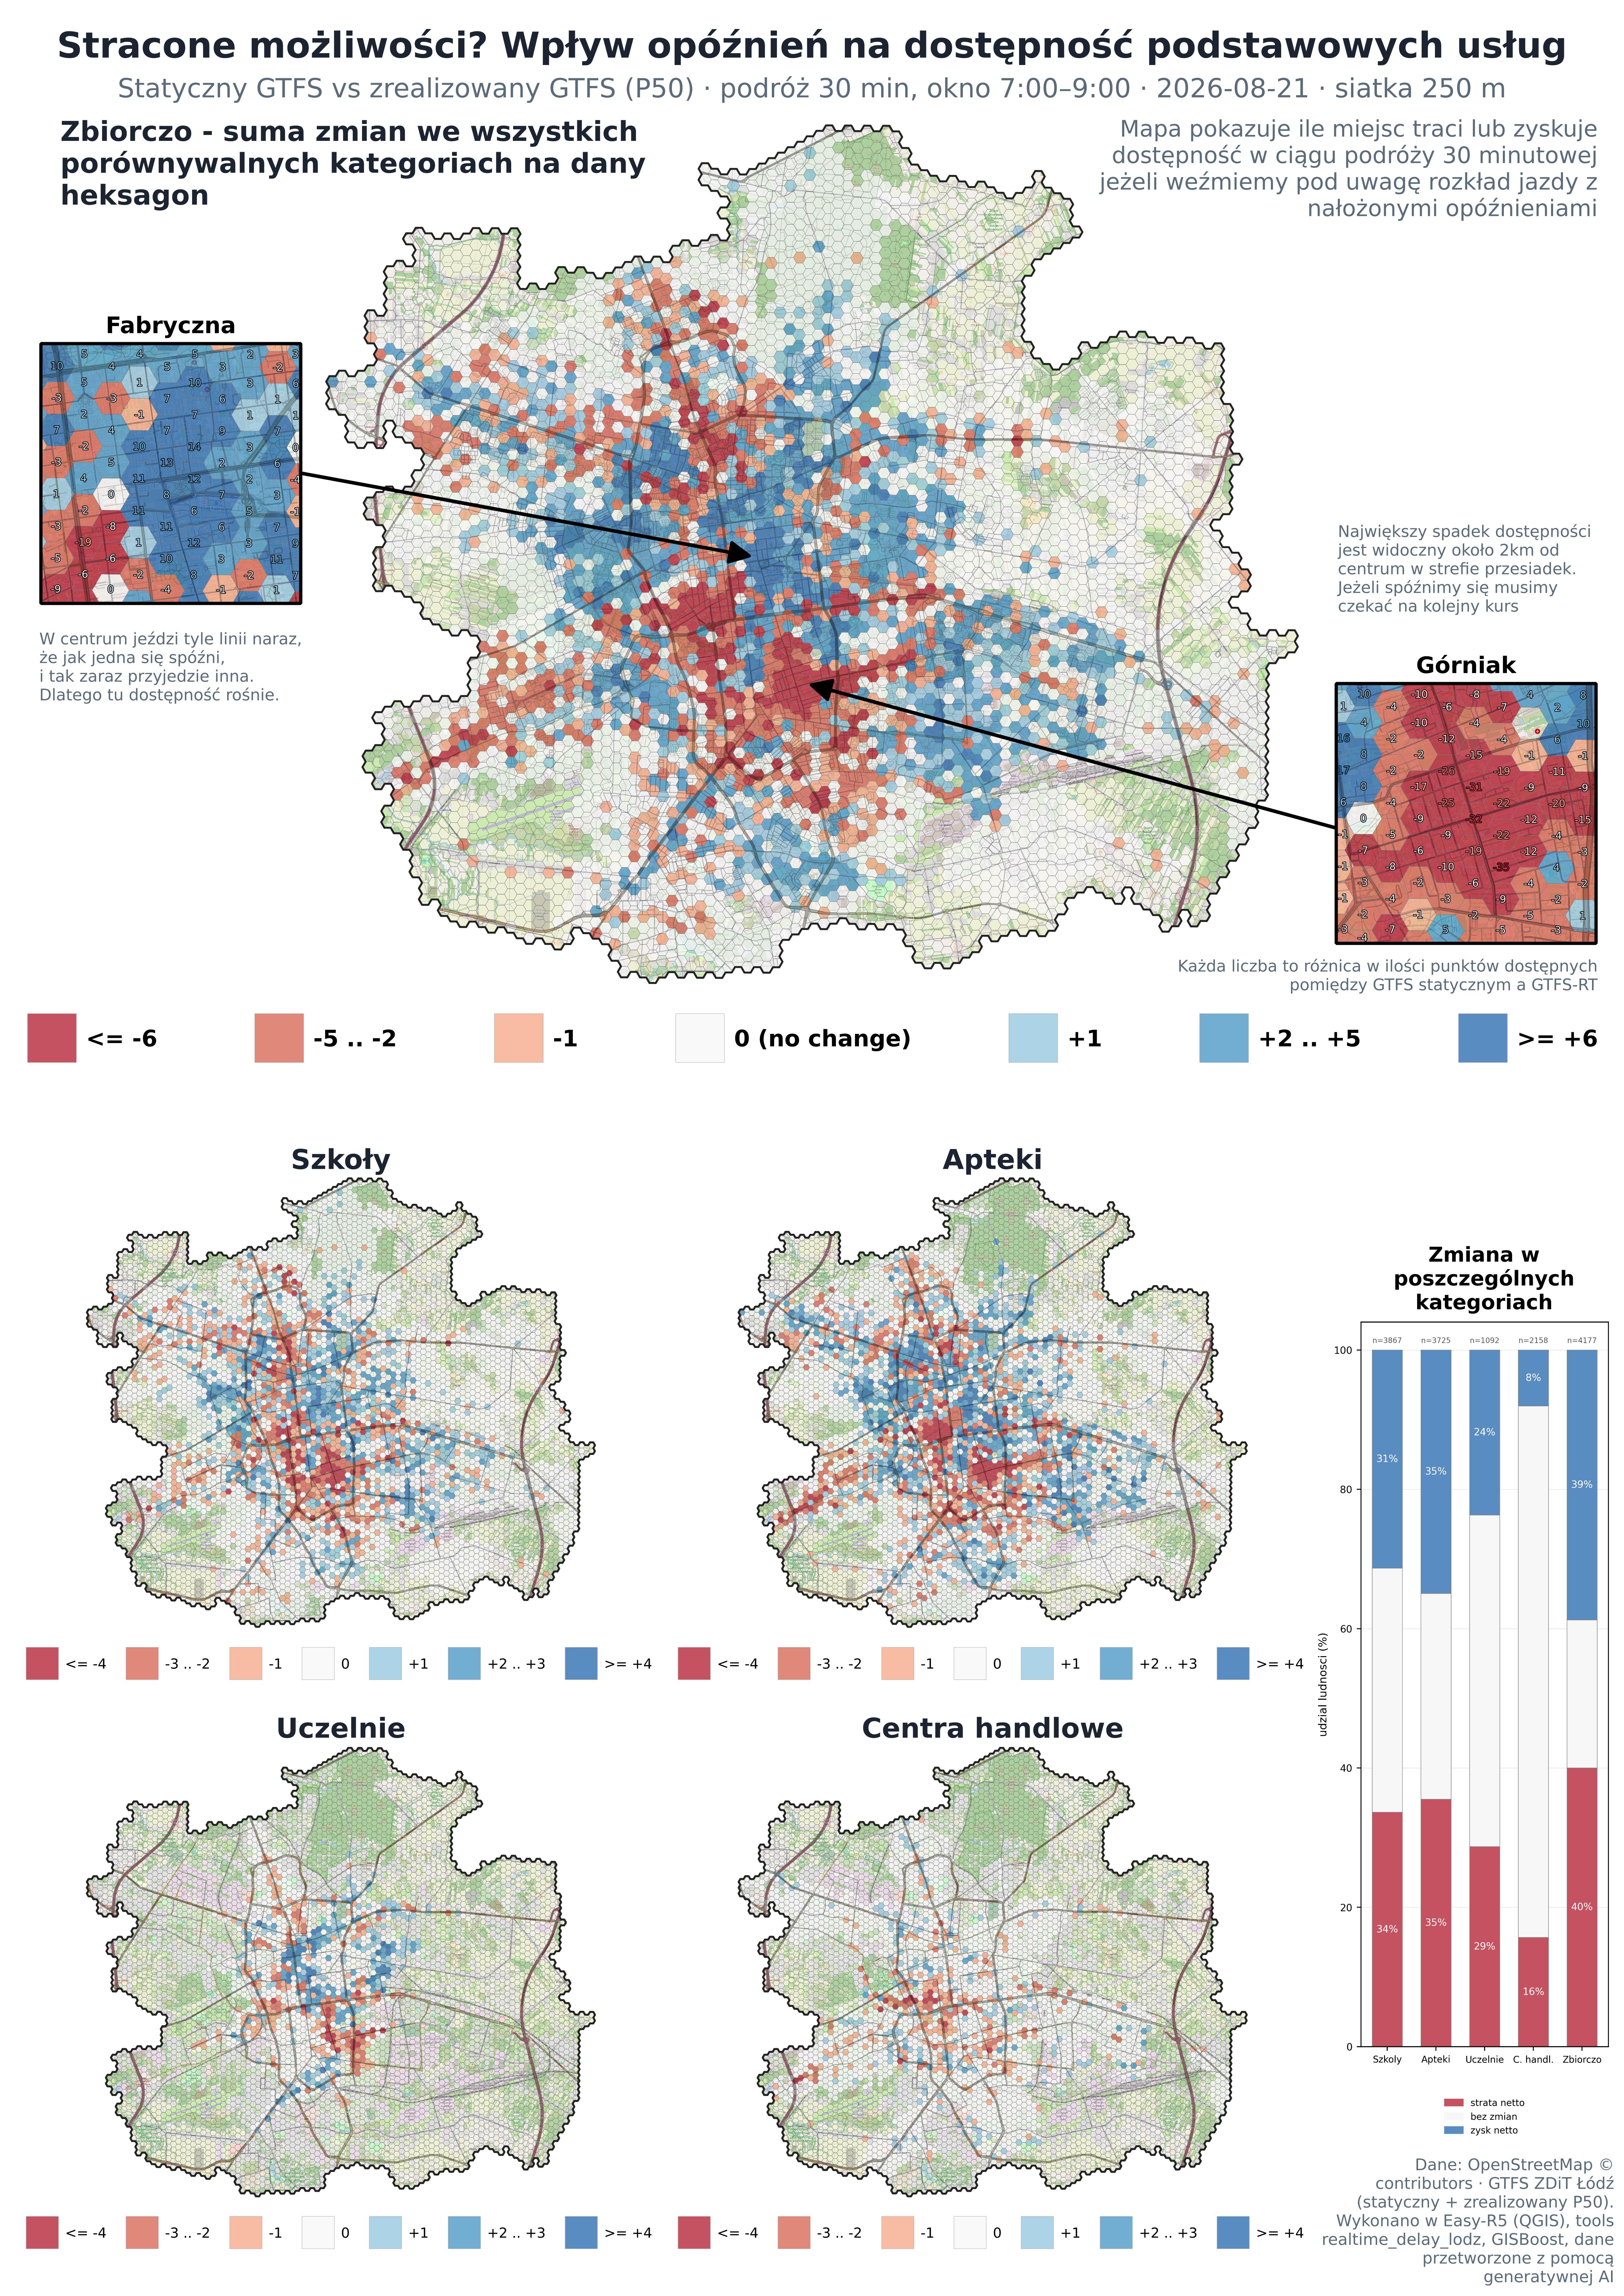
Wynik, który mnie zaskoczył: nie ma gradientu „im bliżej centrum, tym gorzej". Zamiast tego ostry dołek w pierścieniu 2–3 km od środka ciężkości populacji (średnia ważona populacją net_delta ≈ −2,4 przy siatce 250 m), a reszta miasta w granicach ±0,5. Samo centrum (0–1 km) wychodzi lekko na plusie — nakłada się tam tyle linii, że spóźnienie jednej niewiele zmienia. Mediana opóźnień w danych to ~0 s, średnia ~10 s — ale przez te 10 s można stracić przesiadkę, a wtedy czeka się nie 10 s dłużej, tylko cały następny takt.
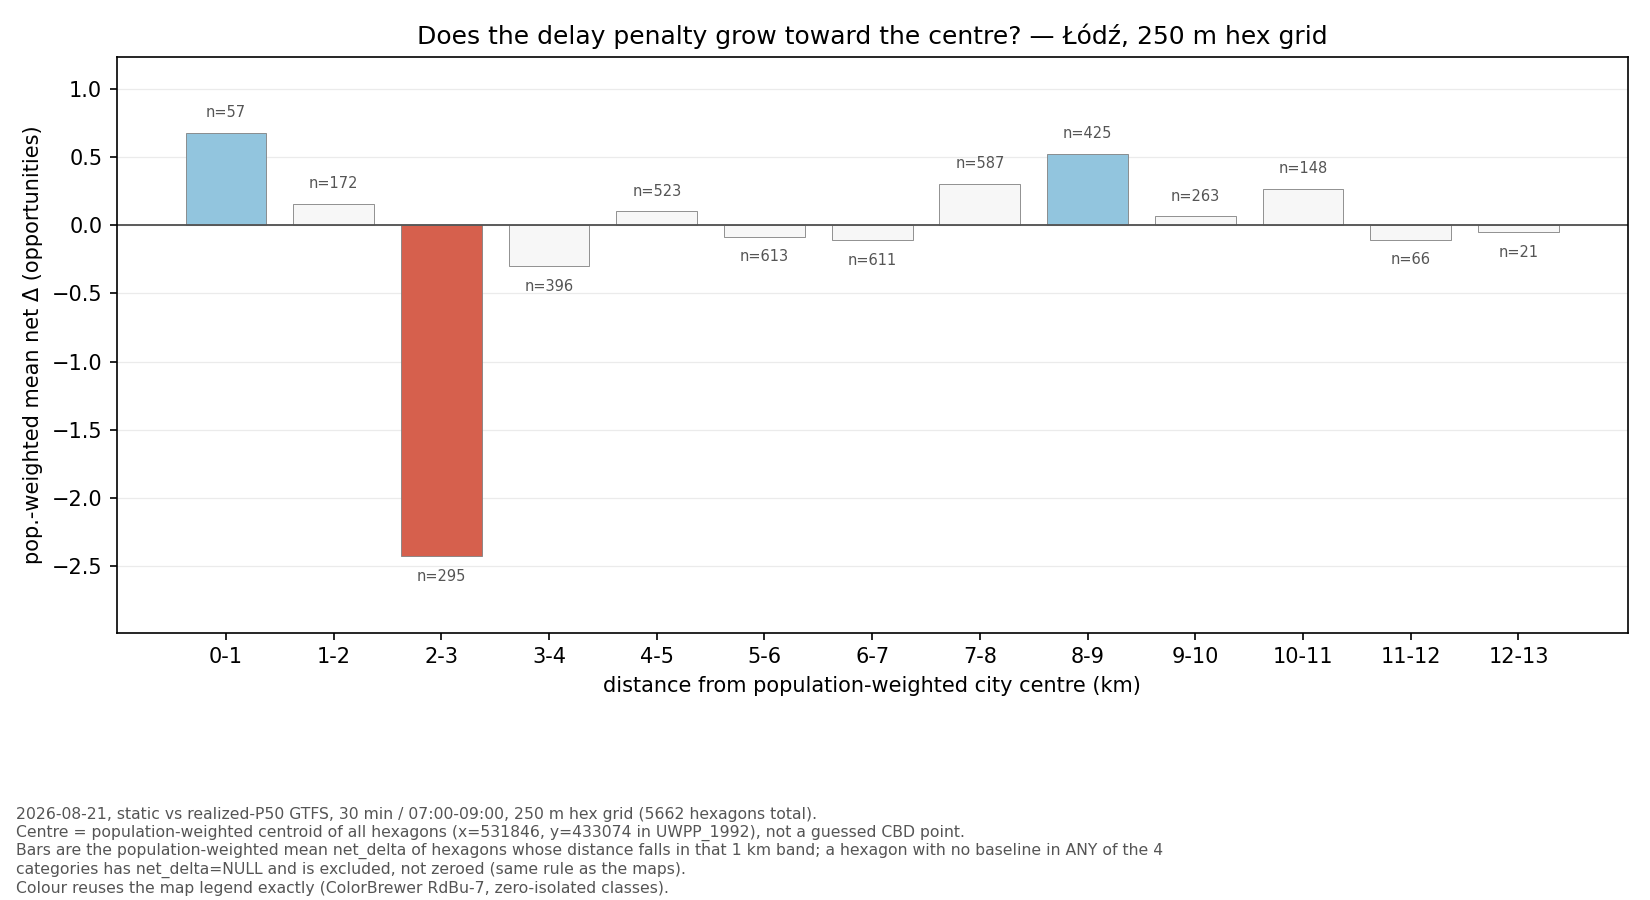
Pierwszy wykres: każdy punkt to jeden heksagon — oś X to odległość od środka ciężkości populacji, oś Y to net_delta (zmiana liczby osiągalnych usług przy przejściu z rozkładu statycznego na zrealizowany). Strata skupia się w wąskim pasie 2–3 km, zamiast rosnąć monotonicznie w stronę centrum.
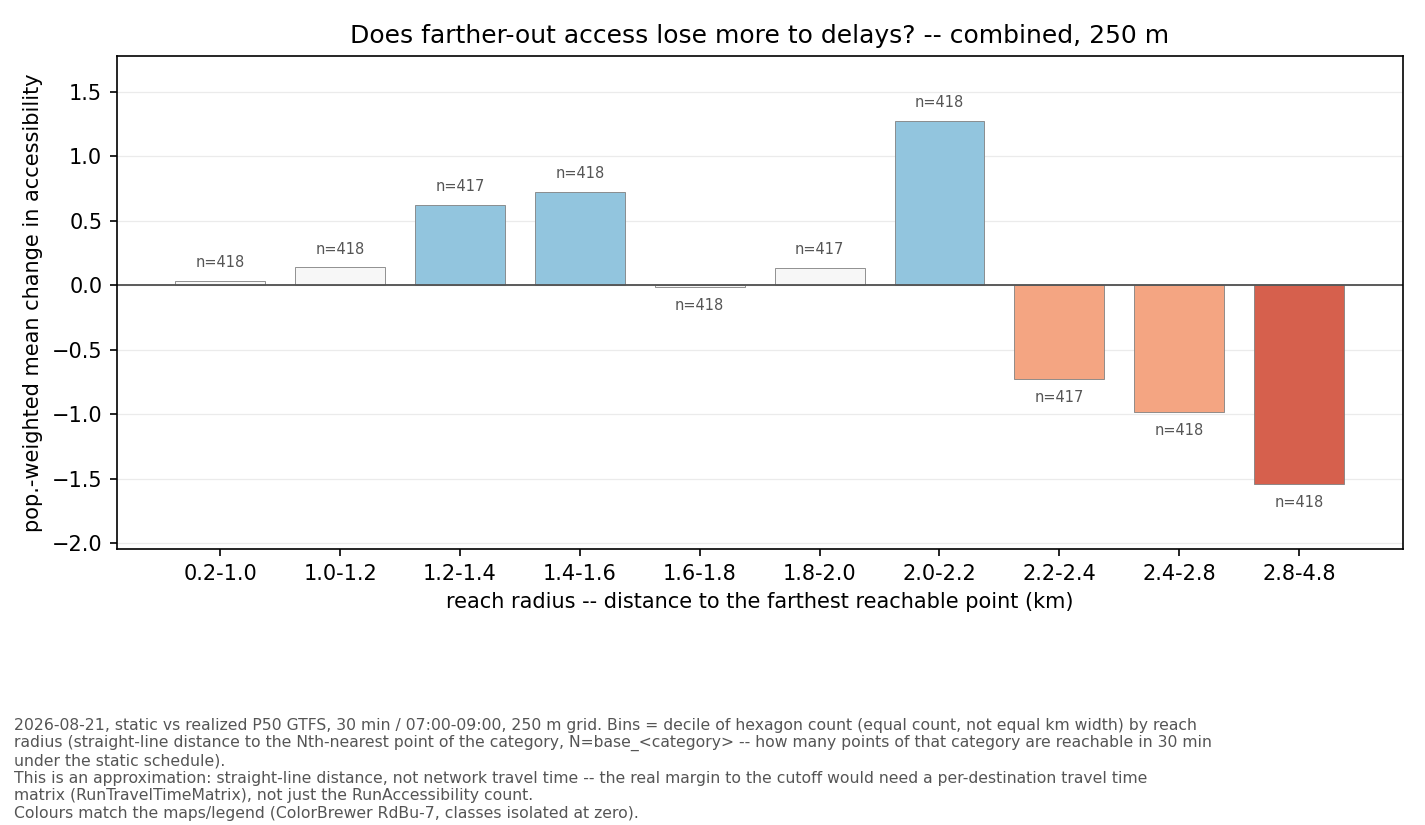
Drugi wykres: dla każdego heksagonu liczę „reach radius" — odległość do najdalszego punktu osiągalnego w 30 minut. Heksagony, które już przy rozkładzie statycznym ledwo mieszczą się w progu (mały zapas czasu), tracą przy opóźnieniach systematycznie więcej niż te z zapasem. To domyka mechanizm: drobne opóźnienie wypycha graniczny przejazd poza próg.
Uczciwe zastrzeżenie do dyskusji: szkoły i apteki zmieniają znak efektu między siatką 250 a 500 m. To przykład MAUP (Modifiable Areal Unit Problem) dostępność ze sztywnym progiem 30 min jest wrażliwa na to, po której stronie progu wypada dojazd, a centroid większego heksagonu ląduje na innym przystanku. Dlatego nie podaję jednej liczby „dla miasta" bez podania rozdzielczości.
Interaktywna wersja map. Metoda, skrypty i projekt QGIS: w repo, katalog tools/realtime_delay_lodz/.
Wtyczka jest na wczesnym etapie. Jestem bardzo ciekaw uwag, zwłaszcza od osób, które robiły podobne analizy w QGIS na OTP albo r5py. Co byłoby dla Was najważniejsze w kolejnych wersjach?